Razcep LU
Za rešitev sistema linearnih enačb zahteva Gaussov eliminacijski postopek najmanjše število računskih operacij.
V primeru, ko se matrika koeficientov ne spreminja in se spreminja zgolj vektor konstant , se je mogoče izogniti ponovni Gaussovi eliminaciji matrike koeficientov. Z razcepom matrike lahko pridemo do rešitve z manj računskimi operacijami. V ta namen si bomo pogledali razcep LU!
Poljubno matriko lahko zapišemo kot produkt dveh matrik:
Pri tem je možnosti za zapis matrik in neskončno veliko.
Pri razcepu LU zahtevamo, da je matrika spodnje trikotna in matrika zgornje trikotna:
Vsaka od matrik in ima neničelnih elementov; skupaj torej neznank. Znana matrika definira vrednosti. Za enolično določitev matrik in torej manjka enačb. Tukaj bomo uporabili razcep LU, ki dodatne enačbe pridobi s pogojem , .
Sistem linearnih enačb:
torej zapišemo z razcepom matrike :
Do rešitve sistema sedaj pridemo tako, da rešimo dva trikotna sistema enačb.
Razcep LU matrike koeficientov 
V nadaljevanju bomo pokazali, da Gaussova eliminacija dejansko predstavlja razcep LU matrike koeficientov . Pri tem si bomo pomagali s simbolnim izračunom, zato uvozimo paket sympy:
import sympy as sym # uvozimo sympy
sym.init_printing() # za lep prikaz izrazov
Prikaz začnimo na primeru simbolno zapisanih matrik in dimenzije :
L21, L31, L32 = sym.symbols('L21, L31, L32')
U11, U12, U13, U22, U23, U33 = sym.symbols('U11, U12, U13, U22, U23, U33')
L = sym.Matrix([[  1,   0,  0],
                [L21,   1,  0],
                [L31, L32,  1]])
U = sym.Matrix([[U11, U12, U13],
                [  0, U22, U23],
                [  0,   0, U33]])
Matrika koeficientov zapisana z elementi matrik in torej je:
A = L*U
AIzvedimo sedaj Gaussovo eliminacijo nad matriko koeficientov .
S pomočjo prve vrstice izvedemo Gaussovo eliminacijo v prvem stolpcu:
A[1,:] -= L21 * A[0,:]
A[2,:] -= L31 * A[0,:]
ANadaljujemo v drugem stolpcu:
A[2,:] -= L32 * A[1,:]
AIz zgornje eliminacije ugotovimo:
matrika je enaka matriki, ki jo dobimo, če izvedemo Gaussovo eliminacijo nad matriko koeficientov .
izven diagonalni členi so faktorji, ki smo jih uporabili pri Gaussovi eliminaciji.
Numerična implementacija razcepa LU
Numerično implementacijo si bomo pogledali na sistemu, ki je definiran kot:
import numpy as np

A = np.array([[8, -6, 3],
              [-6, 6, -6],
              [3, -6, 6]], dtype=float)
b = np.array([-14, 36, 6], dtype=float)
Izvedimo Gaussovo eliminacijo in koeficiente, s katerim množimo pivotno vrsto m, shranimo v matriko L na mesto z indeksi, kot jih ima v matriki eliminirani element.
(v, s) = A.shape # v=število vrstic, s=število stolpcev
U = A.copy()     # pripravimo matriko U kot kopijo A
L = np.zeros_like(A) # pripravimo matriko L dimenzije enake A (vrednosti 0)
## eliminacija
for p, pivot_vrsta in enumerate(U[:-1]):
    for i, vrsta in enumerate(U[p+1:]):
        if pivot_vrsta[p]:
            m = vrsta[p]/pivot_vrsta[p]
            vrsta[p:] = vrsta[p:]-pivot_vrsta[p:]*m
            L[p+1+i, p] = m
    print('Korak: {:g}'.format(p))
    print(U)
Korak: 0
[[ 8. -6. 3. ]
[ 0. 1.5 -3.75 ]
[ 0. -3.75 4.875]]
Korak: 1
[[ 8. -6. 3. ]
[ 0. 1.5 -3.75]
[ 0. 0. -4.5 ]]
Larray([[ 0. , 0. , 0. ],
[-0.75 , 0. , 0. ],
[ 0.375, -2.5 , 0. ]])Dopolnimo diagonalo :
for i in range(v):
L[i, i] = 1.Larray([[ 1. , 0. , 0. ],
[-0.75 , 1. , 0. ],
[ 0.375, -2.5 , 1. ]])Sedaj rešimo spodnje trikotni sistem enačb :
## direktno vstavljanje
y = np.zeros_like(b)
for i, b_ in enumerate(b):
y[i] = (b_ - np.dot(L[i, :i], y[:i])) yarray([-14. , 25.5, 75. ])Nadaljujemo z reševanjem zgornje trikotnega sistema :
Uarray([[ 8. , -6. , 3. ],
[ 0. , 1.5 , -3.75],
[ 0. , 0. , -4.5 ]])yarray([-14. , 25.5, 75. ])## obratno vstavljanje
x = np.zeros_like(b)
for i in range(v-1, -1,-1):
x[i] = (y[i] - np.dot(U[i, i+1:], x[i+1:])) / U[i, i]
xarray([-14. , -24.66666667, -16.66666667])Kakor smo navedli zgoraj, ob spremembi vektorja konstant ponovna Gaussova eliminacija ni potrebna. Izvesti je treba samo direktno in nato obratno vstavljanje. Poglejmo primer:
b = np.array([-1., 6., 7.])
y = np.zeros_like(b)
for i, b_ in enumerate(b):#direktno vstavljanje
    y[i] = (b_ - np.dot(L[i, :i], y[:i]))
x = np.zeros_like(b)
for i in range(v-1, -1,-1):# obratno vstavljanje
    x[i] = (y[i] - np.dot(U[i, i+1:], x[i+1:])) / U[i, i]
x
array([-4.33333333, -7.88888889, -4.55555556])A.dot(x)array([-1., 6., 7.])Pivotiranje
Poglejmo si spodnji sistem enačb:
A = np.array([[0, -6, 6],
              [-6, 6, -6],
              [8, -6, 3]], dtype=float) # poskusite tukaj izpustiti dtype=float in preverite rezultat
b = np.array([6, 36, -14], dtype=float)
Če bi izvedli Gaussovo eliminacijo v prvem stolpcu matrike :
A[1,:] - A[1,0]/A[0,0] * A[0,:]C:\Users\janko\AppData\Local\Temp\ipykernel_17316\3999418912.py:1: RuntimeWarning: divide by zero encountered in scalar divide
A[1,:] - A[1,0]/A[0,0] * A[0,:]
C:\Users\janko\AppData\Local\Temp\ipykernel_17316\3999418912.py:1: RuntimeWarning: invalid value encountered in multiply
A[1,:] - A[1,0]/A[0,0] * A[0,:]
array([ nan, -inf, inf])Opazimo, da imamo težavo z deljenjem z 0 v prvi vrstici. Elementarne operacije, ki jih nad sistemom lahko izvajamo, dovoljujejo zamenjavo poljubnih vrstic. Sistem lahko preuredimo tako, da pivotni element ni enak 0. Vseeno se lahko zgodi, da ima pivotni element, s katerim delimo, zelo majhno vrednost . Ker bi to povečevalo zaokrožitveno napako, izmed vseh vrstic za pivotno vrstico izberemo tisto, katere pivot ima največjo absolutno vrednost.
Če med Gaussovo eliminacijo zamenjamo vrstice tako, da je pivotni element največji, to imenujemo pivotiranje vrstic ali tudi delno pivotiranje. Tako dosežemo, da je Gaussova eliminacija numerično stabilna.
Pokazati je mogoče, da pri reševanju sistema enačb , pri katerem je matrika diagonalno dominantna, pivotiranje po vrsticah ni potrebno. Reševanje je brez pivotiranja numerično stabilno.
Kvadratna matrika dimenzije je diagonalno dominantna, če je absolutna vrednost diagonalnega elementa vsake vrstice večja od vsote absolutnih vrednosti ostalih elementov v vrstici:
Gaussova eliminacija z delnim pivotiranjem
Pogledali si bomo Gaussovo eliminacijo z delnim pivotiranjem. Brez delnega pivotiranja v -tem koraku eliminacije izberemo vrstico za pivotiranje. Pri delnem pivotiranju pa najprej preverimo, ali je -ti diagonalni element po absolutni vrednosti največji element v stolpcu na ali pod diagonalo; če ni, zamenjamo vrstico s tisto vrstico pod njo, v kateri je v stolpcu po absolutni vrednosti največji element. Z delnim pivotiranjem zmanjšamo vpliv zaokrožitvene napake na rezultat.
V kolikor bi izvedli polno pivotiranje, bi poleg zamenjave vrstic uporabili tudi zamenjavo vrstnega reda spremenljivk (zamenjava stolpcev). Polno pivotiranje izboljša stabilnost, se pa redko uporablja in ga tukaj ne bomo obravnavali.
Algoritem za Gaussovo eliminacijo z delnim pivotiranjem torej je:
def gaussova_eliminacija_pivotiranje(A, b, prikazi_korake=False):
    """ Vrne Gaussovo eliminacijo razširjene matrike koeficientov,
    uporabi delno pivotiranje.

    :param A: matrika koeficientov
    :param b: vektor konstant
    :param prikazi_korake: ali izpišem posamezne korake
    :return Ab: trapezna razširjena matrika koeficientov
    """
    Ab = np.column_stack((A, b))
    for p in range(len(Ab)-1):
        p_max = np.argmax(np.abs(Ab[p:,p]))+p
        if p != p_max:
            Ab[[p], :], Ab[[p_max], :] = Ab[[p_max], :], Ab[[p], :]
        pivot_vrsta = Ab[p, :]
        for vrsta in Ab[p + 1:]:
            if pivot_vrsta[p]:
                vrsta[p:] -= pivot_vrsta[p:] * vrsta[p] / pivot_vrsta[p]
        if prikazi_korake:
            print('Korak: {:g}'.format(p))
            print('Pivot vrsta:', pivot_vrsta)
            print(Ab)
return AbAarray([[ 0., -6., 6.],
[-6., 6., -6.],
[ 8., -6., 3.]])Ab = gaussova_eliminacija_pivotiranje(A, b, prikazi_korake=True)Korak: 0
Pivot vrsta: [ 8. -6. 3. -14.]
[[ 8. -6. 3. -14. ]
[ 0. 1.5 -3.75 25.5 ]
[ 0. -6. 6. 6. ]]
Korak: 1
Pivot vrsta: [ 0. -6. 6. 6.]
[[ 8. -6. 3. -14. ]
[ 0. -6. 6. 6. ]
[ 0. 0. -2.25 27. ]]
Razcep LU z delnim pivotiranjem
Podobno kakor pri Gaussovi eliminaciji lahko tudi razcep LU razširimo z delnim pivotiranjem. Reševanje tako postane numerično stabilno. Pri tem moramo shraniti informacijo o zamenjavi vrstic, ki jo potem posredujemo v funkcijo za rešitev ustreznih trikotnih sistemov.
def LU_razcep_pivotiranje(A, prikazi_korake=False):
    """ Vrne razcep LU matriko in vektor zamenjanih vrstic pivotiranje,
    uporabi delno pivotiranje.

    :param A: matrika koeficientov
    :param prikazi_korake: izpišem posamezne korake
    :return LU: LU matrika
    :return pivotiranje: vektor zamenjave vrstic (pomembno pri iskanju rešitve)
    """
    LU = A.copy()
    pivotiranje = np.arange(len(A))
    for p in range(len(LU)-1):
        p_max = np.argmax(np.abs(LU[p:,p]))+p
        if p != p_max:
            LU[[p], :], LU[[p_max], :] = LU[[p_max], :], LU[[p], :]
            pivotiranje[p], pivotiranje[p_max] = pivotiranje[p_max], pivotiranje[p]
        pivot_vrsta = LU[p, :]
        for vrsta in LU[p + 1:]:
            if pivot_vrsta[p]:
                m = vrsta[p] / pivot_vrsta[p]
                vrsta[p:] -= pivot_vrsta[p:] * m
                vrsta[p] = m
            else:
                raise Exception('Deljenje z 0.')
        if prikazi_korake:
            print('Korak: {:g}'.format(p))
            print('Pivot vrsta:', pivot_vrsta)
            print(LU)
    return LU, pivotiranje
Poglejmo si primer:
A = np.array([[0, -6, 6],
              [-6, 6, -6],
              [8, -6, 3]], dtype=float)
b = np.array([-14, 36, 6], dtype=float)
lu, piv = LU_razcep_pivotiranje(A, prikazi_korake=True)Korak: 0
Pivot vrsta: [ 8. -6. 3.]
[[ 8. -6. 3. ]
[-0.75 1.5 -3.75]
[ 0. -6. 6. ]]
Korak: 1
Pivot vrsta: [ 0. -6. 6.]
[[ 8. -6. 3. ]
[ 0. -6. 6. ]
[-0.75 -0.25 -2.25]]
V zgornjem primeru smo uporabili kompakten način zapisa trikotnih matrik in ; vsaka je namreč definirana s 6 elementi, pri matriki pa vemo, da so diagonalni elementi enaki 1. Matrika lu tako vsebuje elementov:
luarray([[ 8. , -6. , 3. ],
[ 0. , -6. , 6. ],
[-0.75, -0.25, -2.25]])Na diagonali in nad diagonalo so vrednosti zgornje trikotne matrike , pod diagonalo pa so poddiagonalni elementi matrike . Pri izračunu rešitve bomo upoštevali, da so diagonalne vrednosti enake 1.
Numerični seznam piv nam pove, kako so bile zamenjane vrstice, kar je treba upoštevati pri izračunu rešitve:
pivarray([2, 0, 1])Določimo sedaj še rešitev (koda za računanje rešitve je v modulu orodja.py)
from moduli import orodjar = orodja.LU_resitev_pivotiranje(lu, b, piv)
rarray([ -3.66666667, -14.11111111, -16.44444444])Preverjanje rešitve:
A@rarray([-14., 36., 6.])Modul SciPy
Modul SciPy temelji na numpy modulu in vsebuje veliko različnih visokonivojskih programov/modulov/funkcij. Teoretično ozadje modulov so seveda različni numerični algoritmi; nekatere spoznamo tudi v okviru tega učbenika. Dober vir teh numeričnih algoritmov v povezavi s SciPy predstavlja dokumentacija. Za odličen uvod v SciPy si lahko ogledate YouTube posnetek: SciPy Tutorial (2022): For Physicists, Engineers, and Mathematicians.
Kratek pregled hierarhije modula:
Linearna algebra (scipy.linalg)
Integracija (scipy.integrate)
Optimizacija (scipy.optimize)
Interpolacija (scipy.interpolate)
Fourierjeva transformacija (scipy.fft)
Redke matrike (scipy.sparse)
Statistika (scipy.stats)
Procesiranje signalov (scipy.signal)
Posebne funkcije (scipy.special)
Večdimenzijsko procesiranje slik (scipy.ndimage)
Delo z datotekami (scipy.io)
V sledečih predavanjih si bomo nekatere podmodule podrobneje pogledali.
Poglejmo si, kako je znotraj SciPy implementiran razcep LU:
from scipy.linalg import lu_factor, lu_solveFunkcija scipy.linalg.lu_factor (dokumentacija):
lu_factor(a, overwrite_a=False, check_finite=True)zahteva vnos matrike koeficientov (ali seznama matrik koeficientov) a, overwrite_a v primeru True z rezultatom razcepa prepiše vrednost a (to je lahko pomembno, da se prihrani spomin in poveča hitrost). Funkcija lu_factor vrne terko (lu, piv):
lu- \ matrika (matrika, ki je enake dimenzije kota, vendar pod diagonalo vsebuje elemente , preostali elementi pa definirajo ; diagonalni elementi imajo vrednosti 1.piv- pivotni indeksi, predstavljajo permutacijsko matrikoP: vrstaimatrikeaje bila zamenjana z vrstopiv[i](v vsakem koraku se upošteva predhodno stanje, malo drugačna logika kot v naši funkcijiLU_razcep_pivotiranje).
lu_factor uporabljamo v paru s funkcijo scipy.linalg.lu_solve (dokumentacija), ki nam poda rešitev sistema:
lu_solve(lu_and_piv, b, trans=0, overwrite_b=False, check_finite=True)lu_and_piv je terka rezultata (lu, piv) iz lu_factor, b je vektor (ali seznam vektorjev) konstant. Ostali parametri so opcijski.
Poglejmo si uporabo:
A = np.array([[0, -6, 6],
              [-6, 6, -6],
              [8, -6, 3]], dtype=float)
b = np.array([-14, 36, 6], dtype=float)
lu, piv = lu_factor(A)luarray([[ 8. , -6. , 3. ],
[ 0. , -6. , 6. ],
[-0.75, -0.25, -2.25]])pivarray([2, 2, 2], dtype=int32)Pridobimo rešitev:
r = lu_solve((lu, piv), b)
r
array([ -3.66666667, -14.11111111, -16.44444444])Preverimo ustreznost rešitve:
A@rarray([-14., 36., 6.])Računanje inverzne matrike
Inverzno matriko h kvadratni matriki reda označimo z . Je matrika reda , takšna, da velja
kjer je enotska matrika.
Najbolj učinkovit način za izračun inverzne matrike od matrike je rešitev matrične enačbe:
Matrika je inverzna matriki : .
Izračun inverzne matrike je torej enak reševanju sistemov linearnih enačb:
kjer je -ti stolpec matrike .
Numerična zahtevnost: izvedemo razcep LU nad matriko (računski obseg reda ) in nato poiščemo rešitev za vsak ( računskih operacij za vsak ). Skupni računski obseg je torej še vedno reda . (Če bi krat izvajali Gaussovo eliminacijo, bi bil obseg reda .)
lu_piv = lu_factor(A)
lu_piv
(array([[ 8. , -6. , 3. ],
[ 0. , -6. , 6. ],
[-0.75, -0.25, -2.25]]),
array([2, 2, 2], dtype=int32))Tukaj se sedaj pokaže smisel razcepa LU; razcep namreč izračunamo samo enkrat in potem za vsak vektor konstant poiščemo rešitev tako, da rešimo dva trikotna sistema. Če bi sisteme reševali po Gaussovi metodi, bi rabili računskih operacij.
Izračunajmo inverzno matriko od matrike . Najprej z uporabo np.identity() pripravimo enotsko matriko:
np.identity(len(A))array([[1., 0., 0.],
[0., 1., 0.],
[0., 0., 1.]])Nato rešimo sistem enačb za vsak stolpec enotske matrike:
A_inv = np.zeros_like(A) #zeros_like vrne matriko oblike in tipa matrike A z vrednostmi 0
for b, a_inv in zip(np.identity(len(A)), A_inv):
    a_inv[:] = lu_solve(lu_piv, b)
A_inv = A_inv.T
Rešitev torej je:
A_invarray([[-1.66666667e-01, -1.66666667e-01, 1.38777878e-17],
[-2.77777778e-01, -4.44444444e-01, -3.33333333e-01],
[-1.11111111e-01, -4.44444444e-01, -3.33333333e-01]])Preverimo rešitev:
A@A_invarray([[ 1.00000000e+00, 0.00000000e+00, 1.11022302e-16],
[ 0.00000000e+00, 1.00000000e+00, -1.11022302e-16],
[ 5.55111512e-17, 0.00000000e+00, 1.00000000e+00]])Rešitev z uporabo Numpy:
#%%timeit
np.linalg.inv(A)
array([[-1.66666667e-01, -1.66666667e-01, 1.38777878e-17],
[-2.77777778e-01, -4.44444444e-01, -3.33333333e-01],
[-1.11111111e-01, -4.44444444e-01, -3.33333333e-01]])Z ustrezno uporabo funkcij iz modula SciPy lahko do rešitve pridemo še hitreje. V funkcijo lu_solve lahko vstavimo vektor ali matriko , katere posamezni stolpec predstavlja nov vektor konstant .
#%%timeit
lu_solve(lu_piv, np.identity(len(A)))
array([[-1.66666667e-01, -1.66666667e-01, 1.38777878e-17],
[-2.77777778e-01, -4.44444444e-01, -3.33333333e-01],
[-1.11111111e-01, -4.44444444e-01, -3.33333333e-01]])Reševanje predoločenih sistemov
from IPython.display import YouTubeVideo
YouTubeVideo('N6upu99LbfQ', width=800, height=300)Kadar rešujemo sistem linearnih enačb z neznankami ter velja in je rang razširjene matrike enak , imamo predoločeni (nekonsistenten) sistem.
Predoločeni (tudi nekonsistenten sistem):
nima rešitve. Lahko pa poiščemo najboljši približek rešitve z metodo najmanjših kvadratov.
Vsota kvadratov preostankov je definirana s skalarnim produktom:
kar preoblikujemo v:
kjer smo upoštevali, da zaradi skalarne vrednosti velja: .
Rešitev enačbe, gradient vsote kvadratov, določa njen minimum:
Tako iz normalne enačbe:
določimo najboljši približek rešitve:
Zgoraj predstavljen postopek je relativno enostaven, je pa numerično zahteven in lahko v nekaterih primerih slabo pogojen; priporočeno je, da v praksi psevdo inverzno matriko izračunamo z uporabo funkcij:
numpy.linalg.pinviz modulanumpy(dokumentacija),Funkcij
pinvalipinvhiz modulascipy.linalg(izbira je odvisna od obravnavanega problema; glejte dokumentacijo),
ki temeljijo na boljših numerični metodah.
Primer sistema z enolično rešitvijo:
## število enačb enako številu neznank
A = np.array([[1., 2],
              [2, 3]])
b = np.array([5., 8])
np.linalg.solve(A, b)
array([1., 2.])Naredimo sedaj predoločeni sistem (funkcija numpy.vstack (dokumentacija) zloži sezname kot vrstice, numpy.random.seed (dokumentacija) ponastavi generator naključnih števil na vrednost semena seed, numpy.random.normal (dokumentacija) pa generira normalno porazdeljeni seznam dolžine size in standardne deviacije scale):
vA = np.vstack([A,A,A])
np.random.seed(seed=0)
vA += np.random.normal(scale=0.01, size=vA.shape) # pokvarimo rešitev -> sistem je predoločen
vA # matrika koeficientov
array([[1.01764052, 2.00400157],
[2.00978738, 3.02240893],
[1.01867558, 1.99022722],
[2.00950088, 2.99848643],
[0.99896781, 2.00410599],
[2.00144044, 3.01454274]])vb = np.hstack([b,b,b])
vb += np.random.normal(scale=0.01, size=vb.shape)
vb # vektor konstantarray([5.00761038, 8.00121675, 5.00443863, 8.00333674, 5.01494079,
7.99794842])Rešimo sedaj predoločen sistem:
Ap = np.linalg.pinv(vA)
Ap.dot(vb)
array([0.94512271, 2.02675939])Vidimo, da predoločeni sistem z naključnimi vrednostmi (simulacija šuma pri meritvi) poda podoben rezultat kakor rešitev brez šuma. V kolikor bi nivo šuma povečevali, bi se odstopanje od enolične rešitve povečevalo.
Psevdo inverzno matriko lahko določimo tudi sami in preverimo razliko z vgrajeno funkcijo:
#%%timeit # preverite hitrost!
Ap2 = np.linalg.inv(vA.T@vA) @ vA.T

Ap2 - Ap
array([[-8.88178420e-16, 2.77555756e-15, 3.33066907e-16,
3.33066907e-15, -1.11022302e-15, 2.99760217e-15],
[ 1.22124533e-15, -6.10622664e-16, 4.44089210e-16,
-6.66133815e-16, 1.11022302e-15, -1.27675648e-15]])Iterativne metode
Pogosto se srečamo z velikimi sistemi linearnih enačb, katerih matrika koeficientov ima malo od nič različnih elementov (take matrike imenujemo redke ali tudi razpršene, angl. sparse).
Pri reševanju takih sistemov linearnih enačb se zelo dobro izkažejo iterativne metode; prednosti v primerjavi z direktnimi metodami so:
računske operacije se izvajajo samo nad neničelnimi elementi (kljub iterativnemu reševanju jih je lahko manj)
zahtevani spominski prostor je lahko neprimerno manjši.
Gauss-Seidelova metoda
V nadaljevanju si bomo pogledali idejo Gauss-Seidelove iterativne metode. Najprej sistem enačb zapišemo kot:
Predpostavimo, da smo v koraku iterativne metode in so znani približki (). Iz zgornje vsote izpostavimo člen :
Ker približki ne izpolnjujejo natančno linearnega problema, lahko iz zgornje enačbe določimo nov približek :
Vsoto smo razdelili na dva dela in za izračun -tega člena upoštevali v -ti iteraciji že določene člene z indeksom manjšim od .
Iterativni pristop prekinemo, ko dosežemo želeno natančnost rešitve :
Zgled
A = np.array([[8, -1, 1],
              [-1, 6, -1],
              [0, -1, 6]], dtype=float)
b = np.array([-14, 36, 6], dtype=float)
Začetni približek:
x = np.zeros(len(A))
x
array([0., 0., 0.])Pripravimo matriko brez diagonalnih elementov (Zakaj? Poskusite odgovoriti spodaj, ko bomo izvedli iteracije.)
K = A.copy() #naredimo kopijo, da ne povozimo podatkov
np.fill_diagonal(K, np.zeros(3)) #spremenimo samo diagonalne elementeKarray([[ 0., -1., 1.],
[-1., 0., -1.],
[ 0., -1., 0.]])for k in range(3):
xk_1 = x.copy()
print(5*'-' + f'iteracija {k}' + 5*'-')
for i in range(len(A)): #opazujte kaj se dogaja, ko to celico poženete večkrat!
x[i] = (b[i]-K[i,:].dot(x))/A[i,i]
print(f'Približek za element {i}', x)
e = np.linalg.norm(x-xk_1)
print(f'Norma {e}')-----iteracja 0-----
Približek za element 0 [-1.75 0. 0. ]
Približek za element 1 [-1.75 5.70833333 0. ]
Približek za element 2 [-1.75 5.70833333 1.95138889]
Norma 6.281360365408393
-----iteracja 1-----
Približek za element 0 [-1.28038194 5.70833333 1.95138889]
Približek za element 1 [-1.28038194 6.11183449 1.95138889]
Približek za element 2 [-1.28038194 6.11183449 2.01863908]
Norma 0.6227976321231091
-----iteracja 2-----
Približek za element 0 [-1.23835057 6.11183449 2.01863908]
Približek za element 1 [-1.23835057 6.13004808 2.01863908]
Približek za element 2 [-1.23835057 6.13004808 2.02167468]
Norma 0.04590845211691733
Preverimo rešitev
A@xarray([-14.01517799, 35.9969644 , 6. ])Metoda deluje dobro, če je matrika diagonalno dominantna (obstajajo pa metode, ki delujejo tudi, ko matrika ni diagonalno dominantna, glejte npr.: J. Petrišič, Reševanje enačb, 1996, str 149: Metoda konjugiranih gradientov).
LU razcep
Vprašanje 1: Enačbe ravnotežja sil in momentov za nosilec na sliki zapišemo:
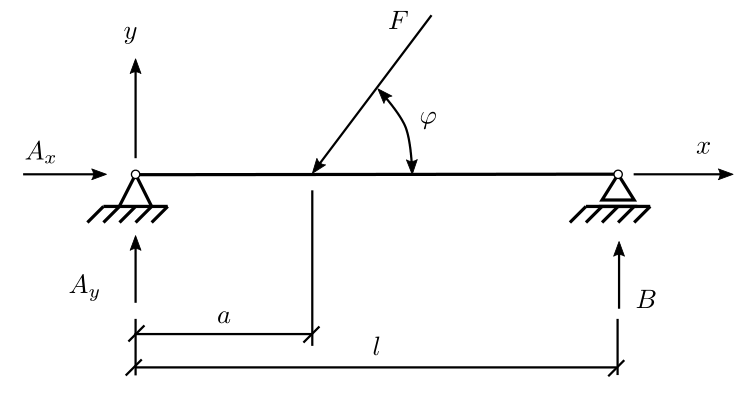
Določite reakcije v podporah za pet različnih kotov iz podanega seznama, tako, da razcep matrike koeficientov opravite le enkrat. Rešitev vsakič izpišite s funkcijo print.
# Podatki
L = 1.5 # m
a = 0.55 # m
F = 85 # N
seznam_phi = [0, np.pi/6, np.pi/4, np.pi/3, np.pi/2]
Računanje inverza matrike
Vprašanje 2: uporabite LU razcep in po zgoraj opisanem postopku določite inverz matrike iz prejšnje naloge.
Reševanje predoločenih sistemov - psevdoinverz
Vprašanje 3: Določite aproksimacijsko premico, ki z minimalno kvadratično napako opiše podanih točk . Parametra in aproksimacijske premice poiščite z rešitvijo sistema linearnih enačb:
kjer so v prvem stolpcu matrike koeficientov koordinate podanih točk, v drugem stolpcu pa same enice. Vektor desnih strani je enak vektorju koordinat obravnavanih točk.
Izrišite na isti sliki množico točk in dobljeno aproksimacijsko premico.
# Podatki
X = np.linspace(1, 10, 100)
Y = 0.7*X - 15.5 + np.random.randn(len(X))
plt.plot(X, Y, 'b.')
Iterativne metode reševanja sistemov linearnih enačb
Vprašanje 4: Z uporabo iterativne Gauss-Seidel metode rešite podan sistem enačb.
Primerjajte rezultat z Gaussovo eliminacijo. Opazujte vpliv števila iteracij na natančnost rešitve.
# Podatek
A = np.array([[-1, 2, 0, 0, 0, 0],
             [-1, 3, 1, 0, 0, 0],
             [0, -1, 4, 1, 0, 0],
             [0, 0, -2, 5, 0, 0],
             [0, 0, 0, 0, 5, 3],
             [0, 0, 0, 0, 1, -3]], dtype=float)

b = np.array([0, 18, 0, 12, 3, 5], dtype=float)